4.9 Ймовірність детекції та трапляння
Цей розділ багато в чому наслідує Розділ 14 “Детекція популяцій та оцінка їх розмірів” у другому виданні книги Ґотеллі та Еллісон “Початки екологічної статистики”. Їх опис є набагато інформативнішим, тож я спонукаю читачів звернутися до цієї книги по додаткові деталі.
До цього моменту ми уявляємо й моделюємо популяцію так, наче ми оперуємо повною інформацією про неї. Наприклад, у випадку агентного моделювання таке припущення має сенс: оскільки комп’ютер симулює кожну окрему особину як індивідуальну сутність, ми можемо в будь-який момент часу порахувати скільки живих особин “існує” в межах симуляції. Всі інші моделі оперують за таким же принципом: на папері, чисельність популяції в логістичному рівнянні чи функціях трапляння є реальним числом, і ми навіть не задумуємось до якої міри воно відображає реальну популяцію.
Якщо ж спитати всякого польового біолога скільки особин виду \(x\) проживає на їх дослідній ділянці, то чи варто очікувати такої ж точної відповіді як дають моделі? У кращому випадку польові біологи нададуть діапазон їх особистої оцінки на око: “на цьому болоті живе від 50 до 100 рослин росички круглолистої Drosera rotundifolia”. Біологи-реалісти, мабуть, взагалі б відповіли що вони не знають. Всякий відповідальний біолог мусить чітко усвідомлювати наскільки невизначеними є їх оцінки щільності популяції, і наскільки їх спостереження та польові дані відображають реальність стану популяції. В цьому розділі ми розглянемо процес польового спостереження як ланку між об’єктивною реальністю та отриманими даними та спробуємо його математично формалізувати, аби зважити на потенційні й неминучі помилки спостереження.
4.9.1 Нульові спостереження теж спостереження!
Почати, мабуть, варто здалеку – із тієї частини цієї книги, де ми говорили про розподіли ймовірності змінних. В тому контексті було побічно згадано таку цікаву родину розподілів, котрі ми обізвали нуль-упередженими, або нуль-надутими (zero-inflated distributions). Цю родину розподілів варто використовувати у випадках коли дані мають значну частку нульових спостережень.
В спостереженні видів таке може траплятись доволі часто. Скажімо, дослідник(-ця) має вибірку випадкових точкових локацій, і на кожній локації він/вона записує скільки особин досліджуваного виду було спостережено. На якихось локаціях вид буде відсутнім, і що ж робити в таких випадках? Можна, звісно, викинути такі локації зі спостережень, чи піти пошукати нові локації на їх заміну. Але такий варіант не завжди прийнятний: по-перше, додаткові локації створюють додаткові логістичні проблеми, і тепер дослідникам необхідно збільшити бюджет на транспорт до нових локацій; по-друге, ніхто не гарантує що нові локації матимуть шуканий вид. По-третє (що є особливо важливим), пошук нових локацій “поки я не знайду мій вид” виключає рандомність локацій дослідження, а отже вибір локацій є заангажованим і не може вважатись випадковим й незалежним.
Гаразд, але що ж тоді робити із порожніми спостереженнями? Якщо таких спостережень небагато, то може з’явитись бажання їх просто виключити із аналізу, хоча це і зменшить розмір вибірки. Але що якщо їх, скажімо, половина? Якщо залишити всі порожні спостереження, то оцінка, наприклад, середньої кількості особин на локації вийде значно заниженою; якщо ж їх викинути, то розмір вибірки не дозволятиме впевнено робити будь-які висновки. У такому випадку дослідникам варто, натомість, краще подумати про статистичну модель того як вони уявляють свою змінну (тобто кількість особин на локації).
Зазвичай, змінна у котрій зацікавлене дослідження уявляється як продукт одного параметру. У найзвичнішому випадку, значення спостереженої змінної мають нормальний розподіл, котрий регулюється середнім значенням79. Однак, у випадку вибірки із багатьма нулями процес генерування спостережень можна уявити як двоступеневий процес із різними параметрами:
чи спостереження дорівнює нулю? цей крок може регулюватись ймовірністю нульового спостереження (\(\pi = P(x_i = 0)\));
якщо спостереження не дорівнює нулю, то яке його середнє значення? цей крок регулюватиметься середнім значенням ненульових спостережень, скажімо, \(\lambda = \bar{x_i} \forall x_i > 0\).
Спробуймо згенерувати такий процес. Скажімо, у вибірці із сотні спостережень половина є нульовими, а ненульові спостереження мають середнє значення 20 особин. Для моделювання ненульових спостережень ми можемо припустити якийсь простий дискретний80 розподіл на кшталт Пуасона:
Code
Оцінка параметрів такої вибірки виглядатиме оберненим чином до того, як ми її згенерували: \(\hat{\pi}\) відповідатиме частці нульових значень, а \(\hat{\lambda}\) – середньому значенню ненульових значень.
## pi = 0.47## lambda = 20.094Звісно, обчислення двох параметрів \(\hat{\pi}\) і \(\hat{\lambda}\) є вдвічі складнішим, аніж обчислення одного середнього арифметичного для всіх спостережень. Однак, з біологічної точки зору, ці два параметри дають набагато інформативнішу картину. Для спостережень між локаціями ми можемо інтерпретувати \(\hat{\pi}\) як ймовірність трапляння – наскільки ймовірно, що випадкова локація матиме наш вид? Інший же параметр, \(\hat{\lambda}\), вказує на чисельність виду на тих локаціях де цей вид присутній.
Цікаво, що в межах популяцій окремих видів чисельність та трапляння позитивно пов’язані. Широко поширені види часто є багаточисельними, а рідкісні види трапляються на небагатьох локаціях – цей зв’язок відомий як зв’язок між траплянням та чисельністю (occupancy-abundance relationship). Звісно, його можна спробувати пояснити статистичними артефактами (малочисельні види важко помітити, тому оцінка їх трапляння виходить заниженою), але й суто екологічні механізми можуть пояснити такий зв’язок: наприклад, чисельність виду і його трапляння між локаціями на периферії географічного поширення є меншою порівняно із ядром ареалу, рівно як часові зміни в доступності ресурсів також викликатимуть позитивний зв’язок між чисельністю та траплянням в межах виду (Gaston et al. 2002). Однак, важливим моментом є і методи обчислення чисельності: будь-яка усереднена оцінка чисельності в нуль-упереджених даних викликатиме позитивний зв’язок між спостереженою чисельністю та траплянням, адже чим більше нульових спостережень в даних (тобто відсутності виду), тим більш заниженими будуть оцінки чисельності цього виду. Декомпозиція нуль-упереджених даних на \(\hat{\pi}\) та \(\hat{\lambda}\), як-то описано вище, все одно вказує на значущу асоціацію між цими двома параметрами в природних популяціях, а отже навіть із врахуванням потенційних артефактів в нуль-упереджених даних варто припускати зв’язок між чисельністю та траплянням (Smith et al. 2012). В природних популяціях чисельність та трапляння є різними сторонами однієї монети. Ми ж можемо побачити ці сторони не тільки на рівні популяції, а й на рівні окремих спостережень.
4.9.2 Ймовірність трапляння і що відбувається на локації
Трапляння виду як подія є характеристикою локації. Вид існує чи не існує на дослідженій локації, а отже трапляння виду на локації можна уявити як процес Бернулі, що генерує бінарну змінну (“так, це вид тут є” чи “ні, його немає”). Зверніть увагу на ледь помітну відмінність постановки питання від нуль-упередженого розподілу: в попередній секції ми оцінювали \(\hat{\pi}\) як ймовірність того, що випадкове спостереження у вибірці багатьох спостережень дорівнюватиме нулю, тобто відсутності виду. Тепер же ми дивимось на окрему локацію, і намагаємось оцінити ймовірність того, що вид існуватиме на цій локації. Таку ймовірність називають ймовірністю трапляння (occupancy probability) і в літературі позначають як \(\psi\).
У найпростішому випадку, якщо припустити що ймовірність трапляння виду між локаціями є фіксованим значенням, ця ймовірність буде еквівалентною до \((1-\pi)\) в нуль-упередженому розподілі. Якщо прийняти кількість досліджених локацій за \(s\), а кількість локацій зайнятих видом – за \(x\) (із чого випливає що \(x \leq s\)), то оцінити ймовірність трапляння можна як
\[\hat{\psi} = \frac{x}{s}\]
На цьому етапі можна уявити, що значення \(\psi\) застосовується лише для виду чи, хіба, окремої популяції. Задля найточнішої оцінки ймовірності трапляння, можна подумати, варто охопити якомога більше випадкових локацій в межах ареалу популяції виду і подивитись скільки із цих локацій зайняті видом. Таким чином ми усереднимо характеристику цілої популяції в межах ареалу до одного значення параметру, що ігноруватиме можливі варіації самих локацій. Кожна локація може мати різні параметри—як-то висоту над рівнем моря, тип середовища, кліматичні характеристики,—і ці параметри можуть мати вплив на присутність виду. Якщо прийняти присутність чи відсутність виду на локації \(l\) за \(w_l\), бінарну присутність виду можна представити як процес Бернулі на кшталт підкидання монети
\[w_l \sim \mathcal{Bernoulli}(\psi_l)\]
де замість одного усередненого значення \(\psi\) ми визначаємо \(\psi_l\), специфічне для окремої локації. Трапляння виду на локаціях відтак можна моделювати із використанням логістичної генералізованої лінійної моделі як функцію характеристик локації \(X_l\):
\[\psi_l = \frac{\exp[\beta_0 + \beta_1X_{1,l} + \beta_2 X_{2,l} + \cdots]}{1 + \exp[\beta_0 + \beta_1X_{1,l} + \beta_2 X_{2,l} + \cdots]}\]
Такий підхід часто використовують для моделювання поширення видів: трапляння-нетрапляння виду можна представити як залежну змінну в статистичній моделі, де предиктори \(X\) відповідають характеристикам середовища, котрі можна оцінити на значних географічних масштабах. На виході із такої моделі можна отримати передбачення ймовірності трапляння, котре доволі просто інтерпретувати (Chandler 2019). Більше про просторове моделювання поширення видів ми поговоримо в розділі про моделювання ніш.
4.9.3 Ймовірність детекції і що відбувається зі спостереженням
Наразі ми досі припускаємо, що ми володіємо точною інформацією щодо присутності чи відсутності виду на локації. Відтак, у наших нуль-упереджених спостереженнях ми припускаємо, що кожен нуль точно відповідає відсутності виду на локації; але що якщо якісь із цих нулів відповідають ситуації коли вид насправді присутній на локації, але дослідники його не виявили в процесі пошуку?
Проведіть наступний уявний експеримент. Ви намагаєтесь знайти певний вид на кожній локації із вашої вибірки. Ви відвідуєте кожну локацію \(T\) разів, скажімо, раз на тиждень протягом \(T\) тижнів. Чи ви очікуєте що значення \(T\) впливатиме на отримані дані? Якщо ви відповіли що ні, тоді одиночного візиту на локацію буде достатньо – кожен раз, коли ви намагаєтесь знайти вид і він є присутній, то ви його знаходите. Якщо ж вам здається що із більшою кількістю візитів ви збільшуєте свої шанси знайти вид (коли він там присутній), то ви визнаєте що процес спостереження неідеальний. Цим ви відкриваєте двері до моделювання ймовірності виявлення, або детекції (detectability).
Аби формально визначити ймовірність детекції, необхідно спершу позначити різницю між реальною присутністю виду і його спостереженням. Раніше ми вже визначили \(w_l\) як присутність виду, тому залишмо це позначення в спокої: \(w_l = 1\) позначатиме що вид справді присутній на локації \(l\), а \(w_l = 0\) означатиме його відсутність. Коли \(w_l = 0\), то скільки б спостережник не старався відвідати локацію повторно, кожне окреме спостереження \(y_{t, l}\) буде приносити значення \(y_{t, l} = 0\). В цій нотації ми позначаємо окреме відвідування локації як \(t\). Отже, ймовірність спостереження виду в будь-який сеанс спостереження за умови, що вид на локації відсутній, дорівнюватиме
\[P(y_{t, l} = 0 | w_l = 0) = 0\]
Як щодо випадків коли вид насправді присутній на локації (тобто \(w_l = 1\))? У такому випадку, спостережник має шанс на детекцію виду протягом акту спостереження із ймовірністю, котру ми позначимо як ймовірність детекції (detection probability = detectability) \(p\):
\[P(y_{t, l} = 1 | w_l = 1) = p\]
Знову ж, ми можемо розглядати спостереження чи неспостереження виду на локації, де він присутній, як процес Бернулі на кшталт підкидання монетки:
\[(y_{t, l} = 1 | w_l = 1) \sim \mathcal{Bernoulli}(p)\]
Згрубша оцінити цю ймовірність доволі нескладно: якщо на локації \(l\) сумарно провели \(t = 1, 2, \cdots, T\) сеансів спостереження і виявили вид \(n\) разів, то ймовірність детекції можна оцінити як
\[\hat{p} = \frac{n}{T}\]
В поняттях статистичних розподілів ймовірності спостереження виду на локації де він присутній відповідає біноміальному розподілу (кількість успіхів \(n\) за підкидання монетки із ймовірністю успіху \(p\) після \(T\) спроб), і оцінщик \(\hat{p}\) вище еквівалентний оцінщику максимальної правдоподібності ймовірності в біноміальному розподілі.
Якщо на хвильку повернутись до чисельності видів, то можна також очікувати що спостережена чисельність виду на локації становитиме лише частку від реальної чисельності \(N\). Коли ймовірність спостерігати окрему особину становить \(p\), то спостережена чисельність виду дорівнюватиме \(n =pN\). На жаль, використання цієї ідеї вимагає не тільки пошуку \(\hat{p}\), а й апроксимації \(\hat{N}\) (в польових дослідженнях ми точно знаємо тільки кількість спостережених особин, але ми не знаємо ані скільки особин перебуває на локації насправді, ані яка ймовірність детекції окремої особини).
На практиці, найпростішим підходом до оцінки ймовірності спостереження будуть повторні спроби спостереження виду на кожній локації. Власне, через те всякі польові дослідження вимагають повторних спостережень, якщо це можливо. Якщо принаймні одне зі спостережень на локації закінчилось виявленням виду, можна сміливо припустити що \(w_l = 1\) і шукати ймовірність детекції як описано вище.
Різні види мають різні ймовірності детекції. Цього можна спокійно очікувати оскільки види різняться своєю біологією, поведінкою, реакцією на людину тощо: коли об’єкти спостереження тікають від спостерігача, завмирають, чи мають криптичне забарвлення, то можна очікувати що їх ймовірності детекції матимуть низькі значення. Цей момент особливо важливий у дослідженнях угруповань, адже спостереження 20 особин виду А (\(n_A = 20\)) і 20 особин виду В (\(n_B = 20\)) не означає, що чисельності видів в угрупованнях є однаковими. Якщо \(p_A \neq p_B\), то рівняння \(n_A = p_AN_A\) й \(n_B = p_BN_B\) тонко натякають, що оцінка реальних чисельностей \(N_A\) й \(N_B\) вимагає зважування на видоспецифічні ймовірності детекції.
Найважливіший урок із концепції ймовірності детекції для польового біолога – то ідея, що в жодному разі не можна припускати, що спостережена чисельність будь-якого виду дорівнює реальній чисельності цього виду. Спостереження видів є результатом процесу польового дослідження, котре не є ідеальним, і ймовірність детекції є меншою за одиницю – не дивно, що стаття, котра ввела цю догму в екологічні дослідження, вважається однією із найбільш впливових статей в історії дисципліни (MacKenzie et al. 2002). До речі, це проблема не тільки зоологів; ботаніки й мікологи не убезпечені від прокляття неідеальної детекції і не перебувають під захистом мантри “принаймні, мої об’єкти дослідження від мене не тікають”. Детекція чи “мічення-відлов” особин нерухомих організмів за повторних пошуків на локації можливі за допомогою координат GPS: якщо за повторного сеансу координати не повторюються, то можна припустити що дослідник пропустив особину рослини, тим зменшуючи \(p\) (Alexander et al. 1997). Це не враховує, втім, що досвідчений дослідник може запам’ятати місцевість і повторно знайти рослини по пам’яті з минулих спостережень.
Подібно до ймовірності трапляння, ймовірність детекції навряд чи є константою. Однак, на відміну від ймовірності трапляння як функції характеристик локації, ймовірність детекції, скоріш, залежить від характеристик сеансу спостереження котрі можуть вплинути на активність особин чи уважність спостережника. Такими предикторами можуть бути погодні умови (спостережник під час сильної грози, мабуть, буде не настільки уважний до своїх об’єктів як в сонячний день), час доби (намагатись спостерігати співочих птахів вночі було б не настільки ефективно порівняно зі сходом сонця) тощо. Відтак, в загальному вигляді, ми можемо моделювати ймовірність детекції як функцію предикторів \(X\)
\[p_t = \frac{\exp[\beta_0 + \beta_1X_{1, t} + \beta_2 X_{2, t} + \cdots]}{1 + \exp[\beta_0 + \beta_1X_{1, t} + \beta_2 X_{2, t} + \cdots]}\]
4.9.4 Статистика спостереження
Коли прийняти що ймовірність детекції \(p<1\), це створює значні проблеми для оцінки ймовірності трапляння \(\psi\): в спостереженнях виду між локаціями стає незрозумілим, котрі нулі відповідають реальній відсутності виду, а котрі – неуспішній детекції на локаціях де цей вид насправді присутній. Дані зі спостереження виду на певній локації \(l\) в певний час \(t\) є результатом двох одночасних процесів—трапляння й детекції (Рис. 4.19)—кожен з яких може мати власні предиктори. Навіть без предикторів, правдоподібність спостереження має доволі загрозливий вигляд (MacKenzie et al. 2002):
\[\mathcal{L}(\psi, p) = \left[ \psi^{l^*} \prod \limits_{t=1}^{T} p_t^{l_t} (1-p_t)^{(l^*-l_t)} \right] \times \left[ \psi \prod\limits_{t=1}^{T} (1-p_t) + (1-\psi) \right]^{(L-l^*)}\]
де \(\psi\) вважається фіксованою на локації \(l\) та \(p\) – фіксованою в час \(t\), \(l^*\) позначає кількість локацій на яких вид було спостережено під час всіх спостережень \(t = 1, 2, \cdots, T\), \(l_t\) позначає кількість локації на яких вид було спостережено під час \(t\)-ого спостереження, \(L\) позначає сумарну кількість локацій в дослідженні, і \(T\) – кількість повторних спостережень на кожній локації.
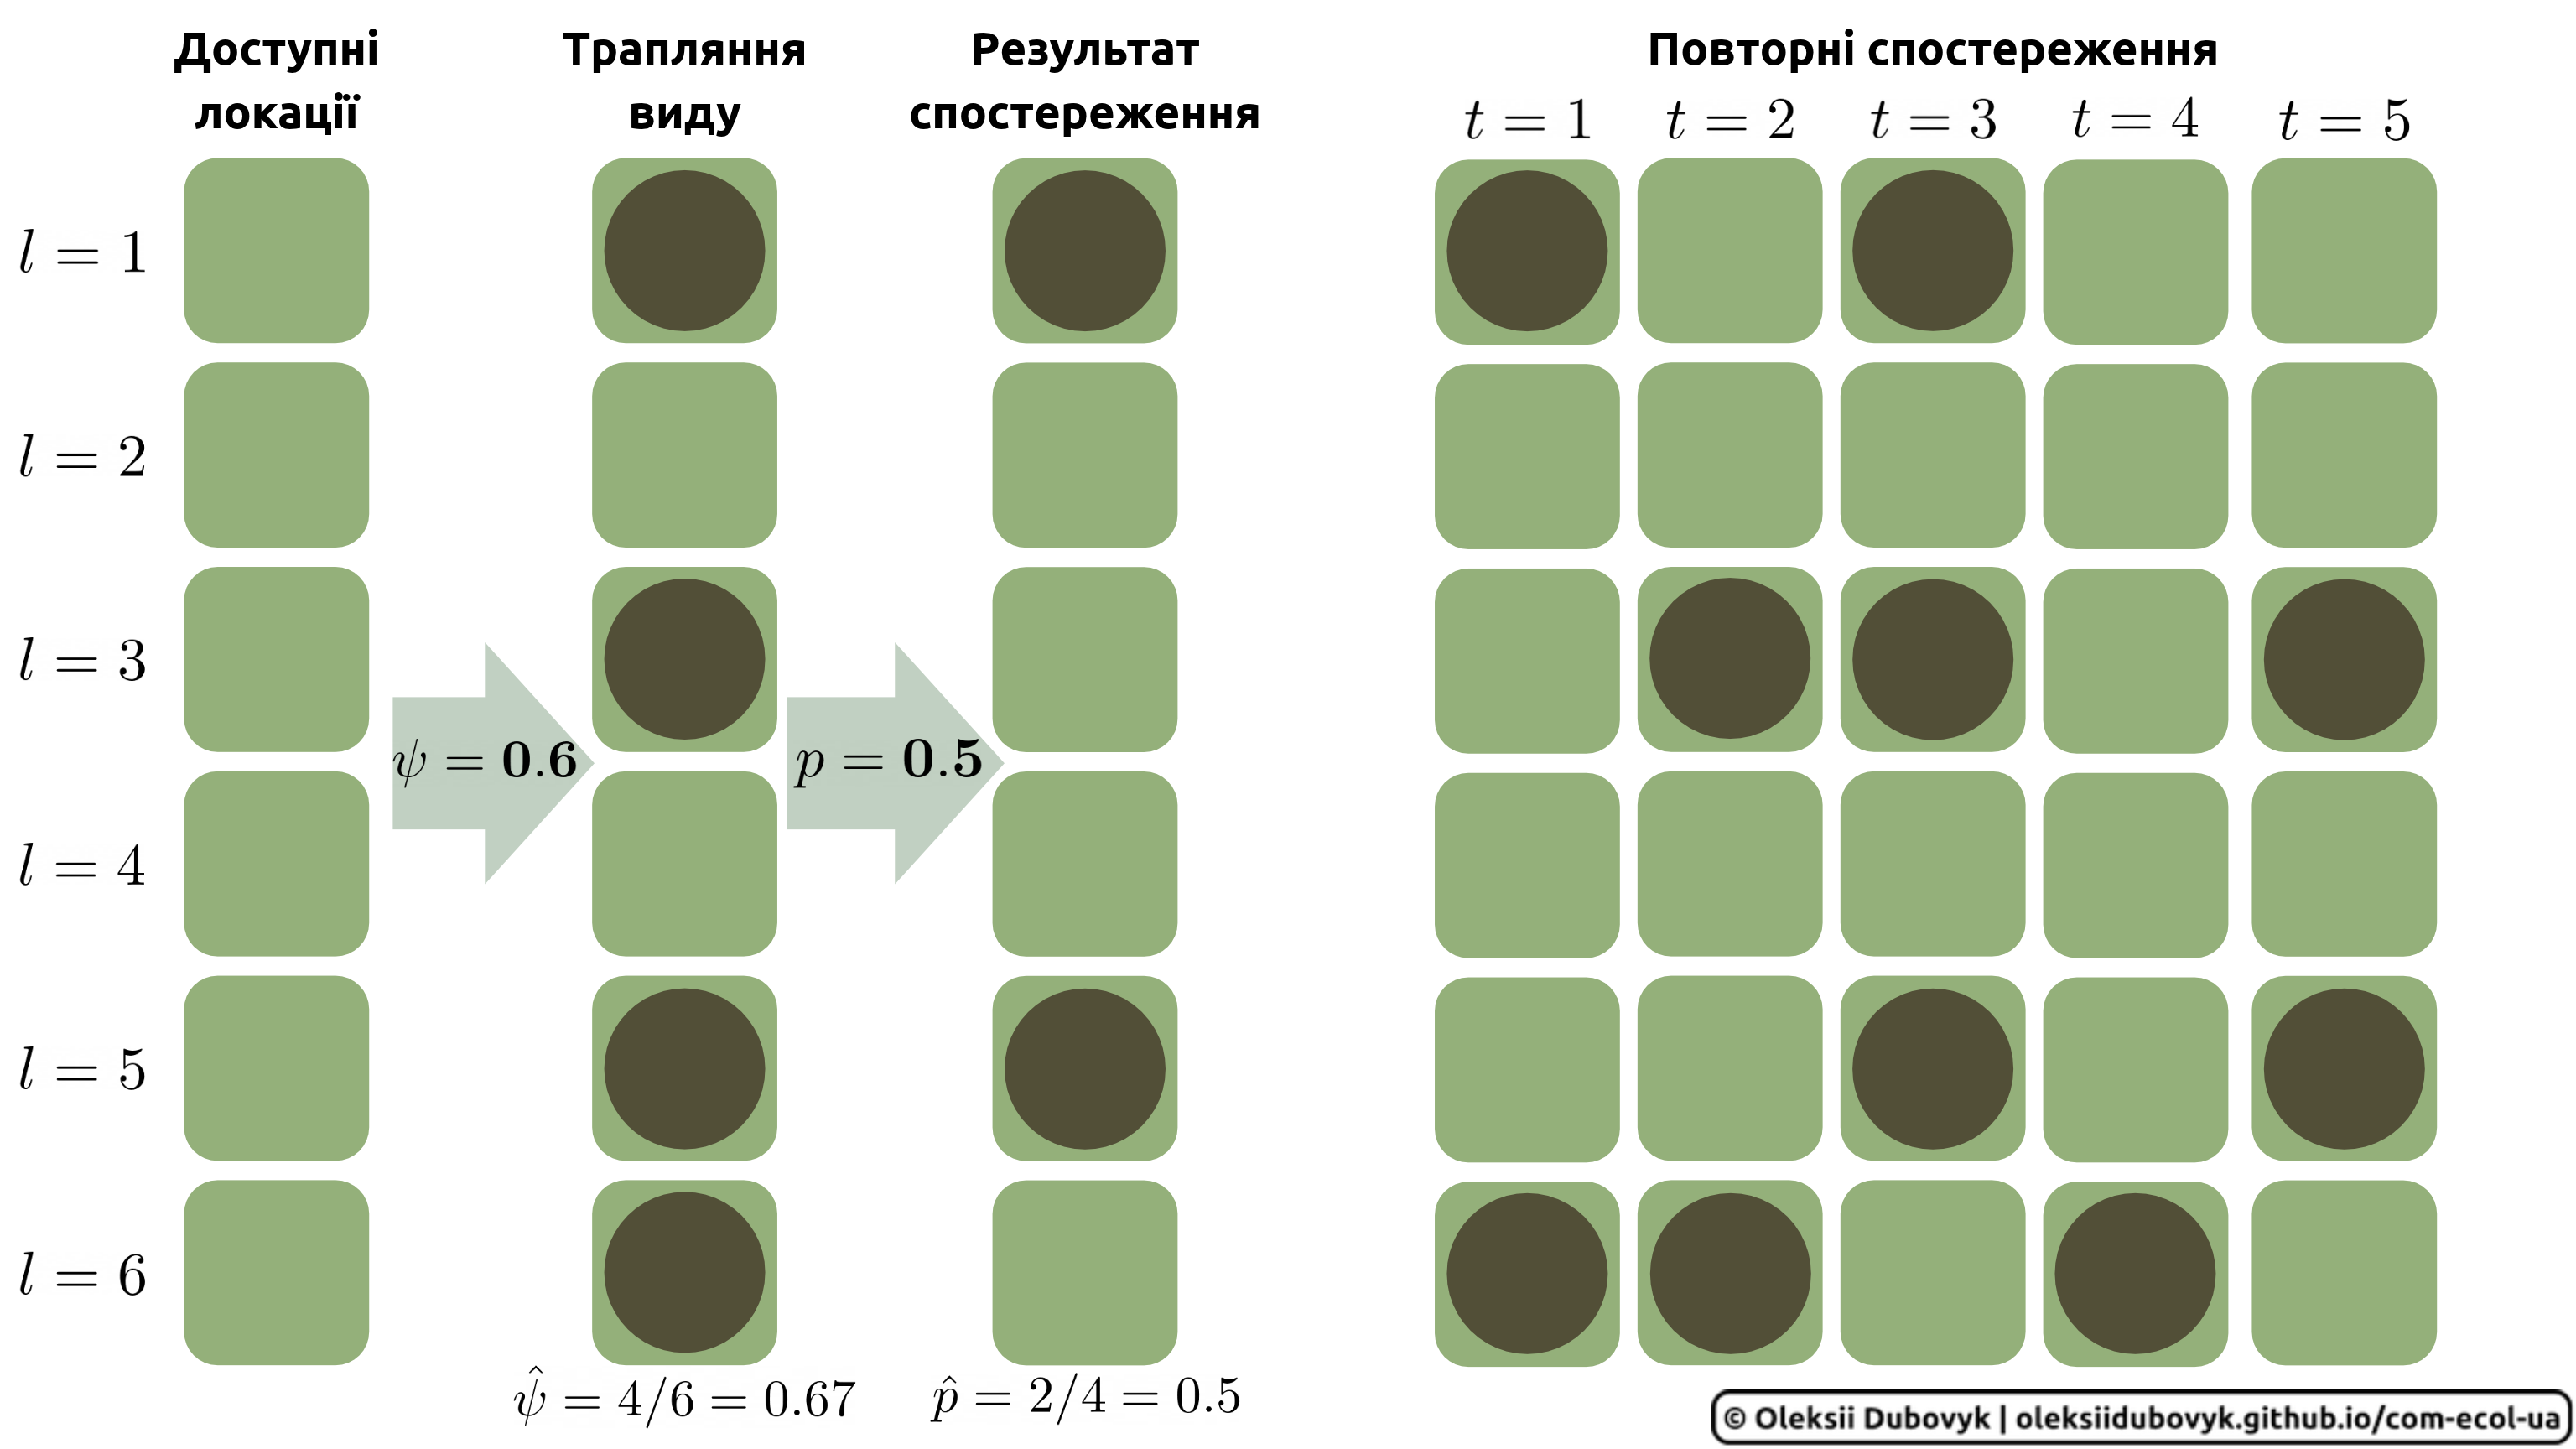
Рис. 4.19: Отримані дані про поширення видів на досліджених локаціях із одного спостереження є результатом трапляння виду на локаціях (\(\psi\)) та неідеальної детекції (\(p < 1\)). Спостереження відсутності виду на локації може бути результатом будь-якого з цих процесів, і спостережник не може зробити висновок чому вид не було спостережено на певній локації: чи тому що він справді там відсутній, чи тому що він уникнув детекції. Повторні спостереження дозволяють точніше оцінити ймовірності трапляння (\(\hat{\psi}\)) і детекції (\(\hat{p}\)).
Підхід об’єднаної моделі із \(\psi\) та \(p\) можна використовувати для уточнення ймовірності трапляння \(\psi\) навіть коли \(p<1\), що дозволяє створювати доволі точні моделі поширення видів на основі даних із неідеальних спостережень. В таких випадках ймовірність детекції \(p\) сприймається як параметр-нюанс: його необхідно оцінити для оптимального обчислення, але власне його значення нас не цікавить – воно необхідне для точної оцінки ймовірності трапляння \(\psi\). Додавання ж предикторів \(\psi\) та \(p\) до такої загальної моделі і порівняння альтернативних моделей з різними предикторами, скажімо, за допомогою інформаційної парадигми (AIC) дозволятиме відповісти на дуже фундаментальні питання щодо того, які фактори визначають поширення виду.
Хоча одні екологи більш зацікавлені в \(\psi\) і предикторах трапляння виду, інші екологи можуть бути зацікавленими і у власне ймовірності детекції \(p\). По-перше, оцінка ймовірності детекції необхідна для оцінки чисельності популяції: по закінченню досліджень ми тільки знаємо результати спостережень, які невідворотно перебувають під впливом \(p\). Коли нас цікавить тільки один вид, звісно, можна припустити що \(p\) є фіксованим видоспецифічним параметром і спостережені чисельності можна порівнювати в межах виду. Такий підхід типовий для багаторічних спостережень за динамікою чисельності популяцій: ми приймаємо чисельність виду на початку спостережень за 100% і кожен рік порівнюємо спостережену чисельність із чисельністю в перший рік (наприклад, Edgar et al. 2023). Найбільшою критикою до такого підходу буде використання безрозмірних відсотків, котрі мало що кажуть про реальний стан популяції і залежать від початкової точки відліку.
По-друге, як вже було згадано вище, екологи угруповань не можуть порівнювати спостережені види напряму, адже ймовірності детекцій різняться між видами. Це доволі значуща проблема для будь-яких обчислень індексів різноманіття, адже всі вони припускають точні дані про розподіл чисельності між видами в угрупованні, і таких даних у дослідника після спостережень нема – вони вимагають поправку на ймовірність детекції. На допомогу можуть прийти N-змішані моделі (N-mixture models, NMM), котрі припускають що в повторних (\(t = 1, 2, \cdots, T\)) спостереженнях на \(l = 1, 2, \cdots, L\) локаціях спостережена чисельність виду \(y_{l, t}\) є біноміальний процесом, котрий визначається реальною чисельністю виду на локації (\(N_l\)) та ймовірністю детекції \(p\):
\[(y_{l, t} | N_l) \sim \mathcal{Binomial}(N_l, p)\]
При цьому, реальна чисельність виду між локаціями відповідає має розподіл Пуасона (хоча негативний біноміальний розподіл також іноді використовують):
\[N_l \sim \mathcal{Poisson}(\lambda)\]
За таких припущень, можливо розробити аналітичні методи (котрі нерідко застосовують Баєсівські пермутації) для оцінки параметрів \(p\) та \(N_l\), котрі, в свою чергу, можуть залежати від предикторів на вибір дослідника (Royle 2004, Madsen & Royle 2023). Повторні спостереження на кожній локації необхідні задля достатньої варіації спостережених чисельностей \(y_{l, t}\), що дозволяє оцінити параметри \(N_l\) та \(p\) і їх невизначеність. Зверніть увагу, що у випадку Пуасонівського процесу ми можемо припустити що \(y_{l, t} < N_l\), адже ми дуже навіть впевнені що \(p < 1\). Деякі дослідники люблять по завершенню повторних обліків прийняти чисельність виду на локації за максимальну спостережену чисельність81, що з точки зору N-змішаної моделі є дуже грубим методологічним порушенням.
N-змішані моделі, як і моделі детекції-трапляння, мають дуже чіткі припущення щодо досліджуваної системи. Найголовніша із них – це закритість популяції до імміграції, еміграції, народжуваності, та смертності. Повторні обліки на кожній локації повинні проводитись на достатньо малих інтервалах часу, аби можна було припустити що реальна чисельність виду \(N_l\) є незмінною між обліками. Коли таке припущення не можна зробити, варто застосувати іншу родину моделей – динамічні моделі трапляння (dynamic occupancy models, DOMs), котрі дозволяють зміни ймовірності трапляння з часом (Kelleher et al. 2025). Крім того, базові NMM припускають фіксоване значення ймовірності детекції в часі та відсутність повторних обліків особин (коли одну особину спостерігають більше ніж один раз і помилково записують як різні особини). Порушення цих припущень можуть зробити висновки із таких моделей ненадійними і оцінки реальної чисельності видів – помилковими (Link et al. 2018). Врешті, порядні екологи навряд чи колись дадуть абсолютну точну, заокруглену до однієї особини оцінку розміру будь-якої популяції: кількість повторних обліків, варіація в умовах середовища, умовах обліків, потенційні зміни розміру популяції в часі разом впливатимуть на точність оцінки реального розміру популяції. Єдиний елемент із цього списку перебуває під контролем свідомих дослідників – умови, в яких проведені обліки. Навіть якщо ми не можемо знати значення ймовірності детекції \(p\), ми можемо зменшити її варіацію якщо забезпечити послідовні та порівнювані умови обліків, зокрема, час доби та умови освітлення, погодні умови, тривалість обліку, кількість обліковців, методи обліку (точкові, трансекти тощо) та інші фактори, котрі можуть потенційно мати ефект на зусилля зі збору вибірки та детекцію особин досліджуваного виду.